htdemucs
Standard auf dieser Seite
- Gesang
- Schlagzeug
- Bass
- Andere Instrumente
Oder Gesang und Instrumental
- SDR
- 8,80 dB
- Zeit
- 20,6 s
- Credits
- 4
2 Spuren: 13,1 s, 3 Credits
Dafür wählen: Die meisten Songs, Karaoke, erstes Reinhören
Modellübersicht · htdemucs, htdemucs_ft und htdemucs_6s
Demucs v4 enthält drei vortrainierte Hybrid-Transformer-Modelle, und Demucs.net führt alle auf Cloud-GPUs aus. Vergleiche ihre Spuren, Qualität, Geschwindigkeit und Kosten.
15 kostenlose Credits pro Monat · Keine Karte erforderlich · Uploads werden automatisch gelöscht
htdemucs, htdemucs_ft und htdemucs_6s sind alle Demucs-v4-Hybrid-Transformer, trainiert auf MUSDB18-HQ plus 800 Songs. Zeit und Credits gelten hier für einen 4-minütigen Song.
htdemucsStandard auf dieser Seite
Oder Gesang und Instrumental
2 Spuren: 13,1 s, 3 Credits
Dafür wählen: Die meisten Songs, Karaoke, erstes Reinhören
htdemucs_ftBeste Qualität auf dieser Seite
Oder zwei; vier feinabgestimmte Modelle darin
2 Spuren: 5 Credits
Dafür wählen: Acapellas und Basslinien, die du veröffentlichen willst
htdemucs_6s6 Spuren auf dieser Seite
Trennt auch vier oder zwei
Keine SDR veröffentlicht
Dafür wählen: Gitarrenparts; Klavier mit Vorsicht
SDR: Signal-to-Distortion-Ratio auf dem MUSDB-HQ-Testsatz, aus Tabelle 1 vonHybrid Transformers for Music Source Separation(Rouard, Massa und Défossez, 2022) und derDemucs README. Zeit: GPU-Zeit auf einer Nvidia A100, September 2026, 320-kbps-MP3-Ausgabe.
Ein Creative-Commons-Song, mit htdemucs auf dieser Seite in vier Spuren getrennt. Hör dir jede Spur im Solo an, bevor du für htdemucs_ft oder htdemucs_6s extra zahlst.
htdemucs ist das erste Hybrid-Transformer-Demucs-Modell und der Standard des demucs-Befehls, trainiert auf MUSDB plus 800 Songs.
Es trennt einen Mix in Gesang, Schlagzeug, Bass und andere Instrumente – oder in Gesang und Instrumental, was die Projektdokumentation Karaoke-Modus nennt.
In Tabelle 1 der Arbeit erreicht es 8,80 dB und liegt damit vor Hybrid Demucs v3 mit 8,34 dB auf denselben Daten und Spleeter mit 5,91 dB.
Wähle es, wenn: du willst Spuren schnell, für einen Karaoke-Track oder einen Übungsmix, oder du bist nicht sicher, welches Modell zum Song passt. Lass es zuerst laufen.
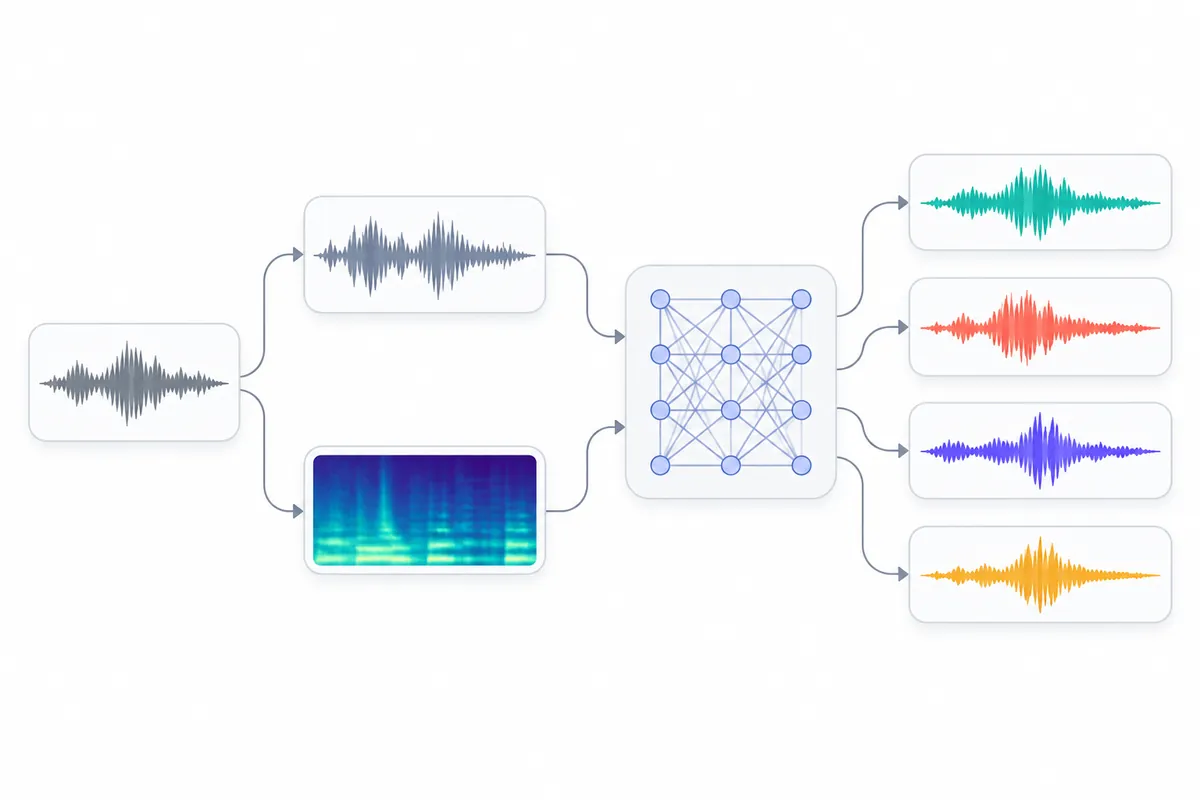
htdemucs_ft ist htdemucs, einmal pro Quelle feinabgestimmt: vier Kopien des Modells, jede weiter trainiert auf Schlagzeug, Bass, andere Instrumente oder Gesang.
Alle vier laufen bei jedem Song, weshalb das README warnt, es „brauche viermal so lange, sei aber vielleicht etwas besser“.
Diese 4x beziehen sich auf die Modellzeit. Hier dauerte es einschließlich Verarbeitung und Export 1,56-mal so lange, weil die MP3-Kodierung bei beiden Modellen gleich viel kostet.
Wähle es, wenn: der Gesang oder der Bass die Spur ist, die du veröffentlichen willst, oder htdemucs hörbares Übersprechen hinterlassen hat. Für einen Party-Karaoke-Track kannst du es überspringen.
htdemucs_6s ergänzt Gitarre und Klavier zu Gesang, Schlagzeug, Bass und anderen Instrumenten – das einzige Demucs-Modell mit diesen beiden Spuren. Hier läuft es über die Option „6 Spuren“.
Demucs 6 Spuren bedeutet htdemucs_6s; ht_demucs6s ist dasselbe Modell, nur anders geschrieben.
Das README sagt klar, dass „die Klavierquelle derzeit nicht gut funktioniert“, und es wird kein SDR dafür veröffentlicht.
Wähle es, wenn: du die Gitarre einzeln brauchst, um eine Stimme zu lernen oder ein Riff zu samplen. Prüfe die Klavier-Spur, bevor du dich darauf verlässt.
Unser Test: der Rocksong in der Demo, der kein Klavier enthält
Gleiche Architektur, gleiche Trainingsdaten, gleiche Ausgaben. Der Tausch: 0,2 dB insgesamt, vor allem bei Gesang und Bass, gegen 1,56-mal so viel Zeit und 1,6-mal so viele Credits.
Die Kosten für einen 4-minütigen Song
| htdemucs | htdemucs_ft | |
|---|---|---|
| Zeit, 4 Spuren | 20,6 s | 32,0 s |
| Credits, 4 Spuren | 4 | 7 |
| Credits, 2 Spuren | 3 | 5 |
Unsere Regel: Starte zuerst htdemucs. Wenn die Gesangsspur Spuren des Schlagzeugs trägt oder der Bass wackelt, lass den Song erneut mit htdemucs_ft laufen. Die meisten Songs brauchen den zweiten Durchlauf nie.
htdemucs, 2 Spuren
3 Credits und etwa 13 Sekunden. Unser Karaoke-Generator öffnet in diesem Modus.
htdemucs_ft, 2 Spuren
Die größten Gewinne erzielt es bei Gesang und Bass.
htdemucs, 4 Spuren
Oder htdemucs_ft, wenn die Bass-Spur veröffentlicht wird. Der Stem-Splitter öffnet mit vier ausgewählten Spuren.
htdemucs_6s
Das einzige Modell mit diesen Quellen. Hör dir die Klavier-Spur an, bevor du ihr vertraust.
htdemucshtdemucs_6s
htdemucs_6s für eine Gitarrenlinie. htdemucs_ft bringt nichts, was du bei Übungslautstärke hören würdest.
htdemucs
Der Standard aus gutem Grund – und der günstigste. Steig erst auf, wenn du hörst, warum.
Alle erreichen im selben Benchmark niedrigere Werte als die Hybrid Transformers – 7,7 dB für Hybrid Demucs v3 in der Tabelle des README –, deshalb betreibt Demucs.net nur htdemucs, htdemucs_ft und htdemucs_6s.
hdemucs_mmimdxmdx_extramdx_qmdx_extra_qKurze Antworten zu htdemucs, htdemucs_ft und htdemucs_6s: ihre Namen und was sie zum Laufen brauchen. Noch Fragen? Melde dich .
Hybrid Transformer. Demucs v4 ersetzte die innersten Schichten von Hybrid Demucs (v3) durch einen Cross-Domain-Transformer-Encoder, der Wellenform und Spektrogramm gleichzeitig liest; mit 800 zusätzlichen Trainingssongs liegt es laut Paper 0,45 dB SDR vor Hybrid Demucs.
Für die reine Modelllaufzeit stimmt das ungefähr: Es laufen vier feinabgestimmte Modelle statt eines. Einschließlich Verarbeitung und Export benötigt htdemucs_ft hier jedoch das 1,56-Fache der Zeit: 32,0 statt 20,6 Sekunden für einen 4-minütigen Song. Die MP3-Kodierung dauert bei beiden Modellen gleich lange.
Keiner; es sind zwei Schreibweisen desselben Sechs-Spuren-Modells. Sein Name im Demucs-Repository ist htdemucs_6s, und es steckt hinter der Option „6 Spuren“ hier.
htdemucs_ft: 9,20 dB bei Gesang in Tabelle 1 des Papers gegenüber 8,93 dB bei htdemucs. Für Karaoke, wo das Instrumental wichtiger ist als der Gesang, reicht meist das Standardmodell; htdemucs_6s ist dafür nicht das richtige Werkzeug, seine zusätzlichen Quellen sind Gitarre und Klavier.
Nicht zuverlässig. Die Autoren sagen, die Klavier-Quelle „funktioniert nicht gut“, und in unserem eigenen Test mit einem Song ohne Klavier kam die Klavier-Spur leer zurück, während die Gitarren-Spur solide war. Nutze htdemucs_6s für Gitarre, hör dir die Klavier-Spur an, bevor du dich darauf verlässt, und verwende htdemucs oder htdemucs_ft, wenn du keins von beiden brauchst.
Ja. Jedes angemeldete Konto kann htdemucs, htdemucs_ft oder htdemucs_6s wählen; sie unterscheiden sich nur in den Credits pro Minute Audio, mit dem 1-, 1,6- und 1,3-Fachen des Standardtarifs.
Wenn du sie selbst ausführst, verlangt die README mindestens 3 GB GPU-Speicher, mit Standardeinstellungen etwa 7 GB; auf einer CPU rechne mit ungefähr dem 1,5-Fachen der Tracklänge. Hier laufen htdemucs, htdemucs_ft und htdemucs_6s auf Cloud-GPUs, sodass nichts davon zutrifft.
Das ursprüngliche Repository sagt, es wird nicht mehr gepflegt, seit sein Autor Meta verlassen hat; ein Fork enthält wichtige Bugfixes. Die vortrainierten Modelle sind davon nicht betroffen: htdemucs, htdemucs_ft und htdemucs_6s sind fertige Gewichte, und genau die führt diese Seite aus.
Lade einen Song hoch, wähle htdemucs, htdemucs_ft oder htdemucs_6s und hör den Unterschied selbst. 15 kostenlose Credits pro Monat, keine Karte nötig.
Song kostenlos trennen